//Novità4 min di lettura
Jev: il modello per decisioni che non scrive nemmeno una riga di testo
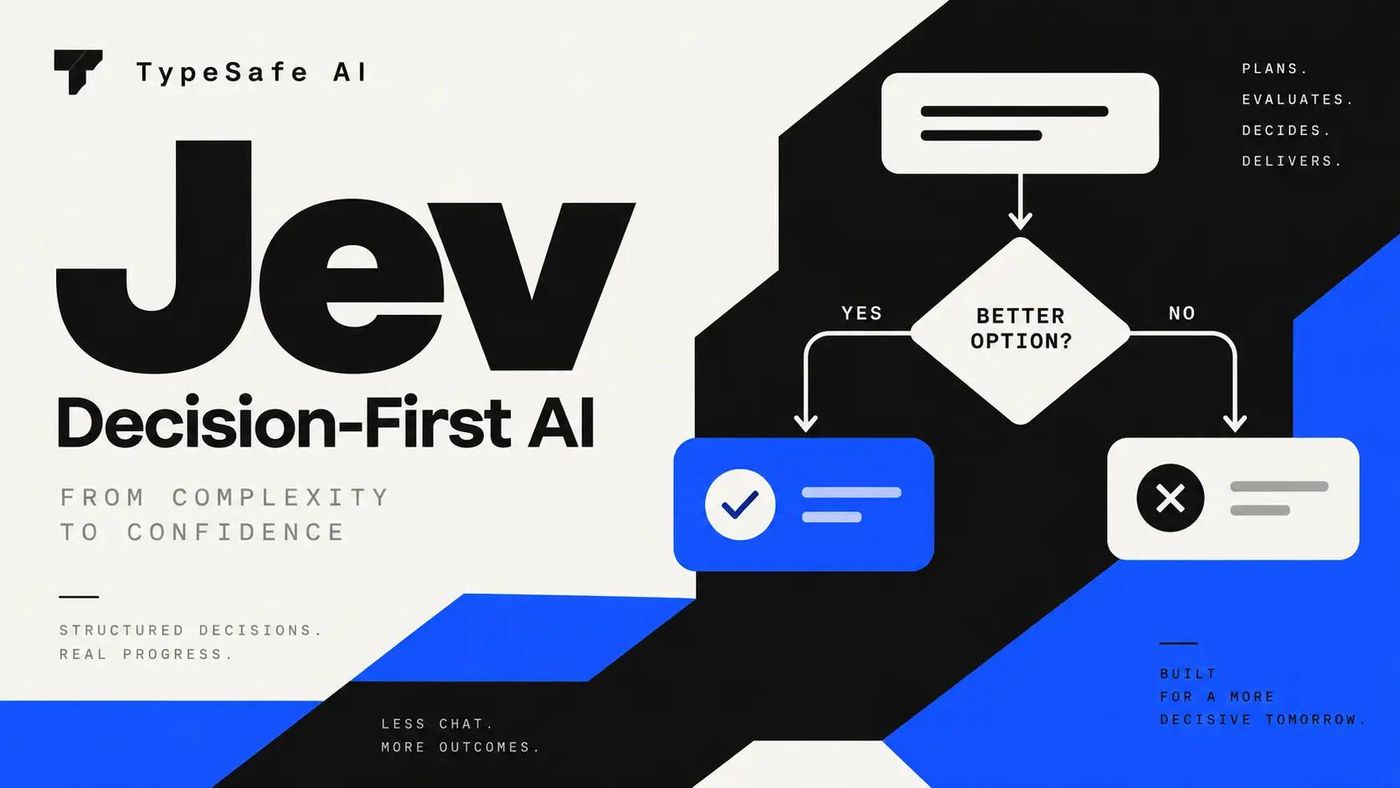
Esiste una nuova categoria di modelli che non genera testo: non scrive, non conversa, non produce codice. Si chiamano System One, dalla distinzione tra pensiero rapido e intuitivo (System 1) e ragionamento lento e deliberato (System 2) resa famosa da Kahneman. Jev ne è il primo esemplare, annunciato da TypeSafe AI in early access il 15 settembre 2026 insieme a un round seed da 40 milioni di dollari guidato da DCVC.
L'idea di partenza: i modelli chat sono lenti e costosi quando serve solo una decisione. Jev prende uno stato (testo, JSON o una lista di stringhe) e un set di domande tipizzate, e valuta tutto in parallelo restituendo valori strutturati con probabilità calibrate, in 70-500 millisecondi end-to-end. L'output è pensato per essere consumato dal codice, non letto da persone.
Le tre primitive
- noul: domanda sì/no, restituisce una probabilità tra 0 e 1 (es. "il messaggio trasmette urgenza?" -> 0.999)
- choice: sceglie tra opzioni non ordinate, restituisce la probabilità di ciascuna più un punteggio di confidence
- score: valuta su una scala ordinata (es. basso/medio/alto), restituisce punteggio continuo, distribuzione e confidence
Tutte le domande si valutano in parallelo sullo stesso stato, in una sola chiamata: aggiungerne altre non aumenta quasi per niente il tempo di risposta, e ciascuna viene valutata in isolamento, senza che una contamini il contesto delle altre. Se una domanda dipende dal risultato di un'altra, servono due chiamate in sequenza.
Perché interessa al vibecoding
Jev non scrive codice e non sostituisce l'LLM del vostro agente. Il suo terreno è tutto ciò che nell'agente non è generazione: il routing del modello (mandare le richieste semplici al modello veloce ed economico, quelle difficili a un modello frontiera), e il controllo delle azioni a rischio prima che vengano eseguite, il pattern di guardrail che finora era chiuso dentro gli harness proprietari. LangChain ha già pubblicato le integrazioni ufficiali (TypeSafeClassifier per la classificazione, AutoModeMiddleware per bloccare le chiamate agli strumenti pericolose prima che partano).
Primi riscontri indipendenti raccolti da TechCrunch: Vercel ha sostituito un classificatore basato su ChatGPT Luna 5.6 di OpenAI con Jev per vagliare la sicurezza dei comandi, ottenendo risultati da 5 a 18 volte più veloci e più accurati; Bryo AI ha trovato Gemini leggermente più accurato ma da 10 a 20 volte più costoso sulla classificazione delle email di business.
Il nome è un manifesto: il paradosso di Jevons
Il nome riprende William Stanley Jevons, l'economista del paradosso per cui rendere più efficiente una risorsa ne aumenta il consumo invece di ridurlo. La tesi di TypeSafe è la stessa applicata all'intelligenza: se una decisione costa una frazione di centesimo e arriva in 100 millisecondi, ne metterete molte di più nei vostri programmi. I numeri di lancio vanno in questa direzione: input a $0.042 per milione di token, output non fatturato perché troppo economico da misurare.
Cosa NON c'è
- I numeri di lancio (70-500ms end-to-end, 40-200x più veloce, 40-400x più economico dei modelli frontiera) sono claim del vendor, misurati sulle workflow di TypeSafe stessa, con un bias che l'azienda dichiara apertamente. Non esiste una verifica indipendente sistematica di quei numeri: i riscontri di terzi sono i test di singoli sviluppatori, non benchmark condivisi.
- Architettura, pesi e paper tecnico non sono pubblicati: TypeSafe dice solo che il modello è basato su transformer, addestrato su dati sintetici con un metodo che chiama RLCD (Reinforcement Learning for Calibrated Decisions).
- "Non può allucinare" è vero per costruzione: l'output sono valori tipizzati scelti tra opzioni definite in anticipo, non stringhe libere. Ma è un modello proprietario in early access: da mettere alla prova, non da dare per scontato.
- L'accuratezza migliore è documentata sull'inglese: le altre lingue sono gestite ma non alla pari, e la documentazione stessa invita a testare sui propri contenuti prima di fidarsi (vale anche per l'italiano).
Che decisioni avete già provato a strappare dal loop chat dei vostri agenti? E per cosa lo usereste subito, routing o guardrail?
Fonti:
- Introducing System One Models & Jev - typesafe.ai, 2026-09-15
- Jev (AI model) - en.wikipedia.org, consultata 2026-10-11
- Introduction - docs.typesafe.ai
- Building a Harness with Jev - langchain.com, 2026-09-17
- A new kind of AI model from a ChatGPT inventor is thrilling developers - techcrunch.com, 2026-09-18
- Models - docs.typesafe.ai (prezzo, limiti e versione corrente)
📌 Questo articolo riassume una discussione su r/vibecodingitalia. Leggi il post originale.
Scritto da
Michael Gasperini@TheStreamCode
Full Stack Developer
Creatore di Vibe Coding Italia, la community italiana sull’intelligenza artificiale. Progetta e sviluppa prodotti con l’AI e ne racconta l’applicazione pratica attraverso guide e articoli.
DeepSeek V4.1 Flash su Mistral: se arriva in Vibe Code, il piano Pro diventa l'offerta migliore
DeepSeek V4.1 Flash 1017 su Mistral costa 0,30 e 1,20 $ per milione di token: oggi è su API e Studio, non in Vibe Code. Se arriva, il piano Pro cambia.
Leggi articolo
Gemini 4 Argon disponibile per gli sviluppatori: 1M di token di output, 77,9% su DeepSWE, prezzo intro a 2/10 dollari
Gemini 4 Argon è disponibile via API, Antigravity e Cloud: contesto da 1M di token, 77,9% su DeepSWE e prezzo intro da $2/$10 al milione fino al 30 novembre.
Leggi articolo
Mistral Pro: 14,99 € al mese + IVA per 255 € di utilizzo Vibe Code (GLM 5.3 compreso)
L'abbonamento Pro di Mistral costa 14,99 € al mese + IVA e include 255 € di utilizzo Vibe Code e 25,5 € di credito API: ottimo per la CLI Vibe.
Leggi articolo