//Novità2 min di lettura
DeepSWE: il benchmark che mostra dove i modelli di coding divergono davvero
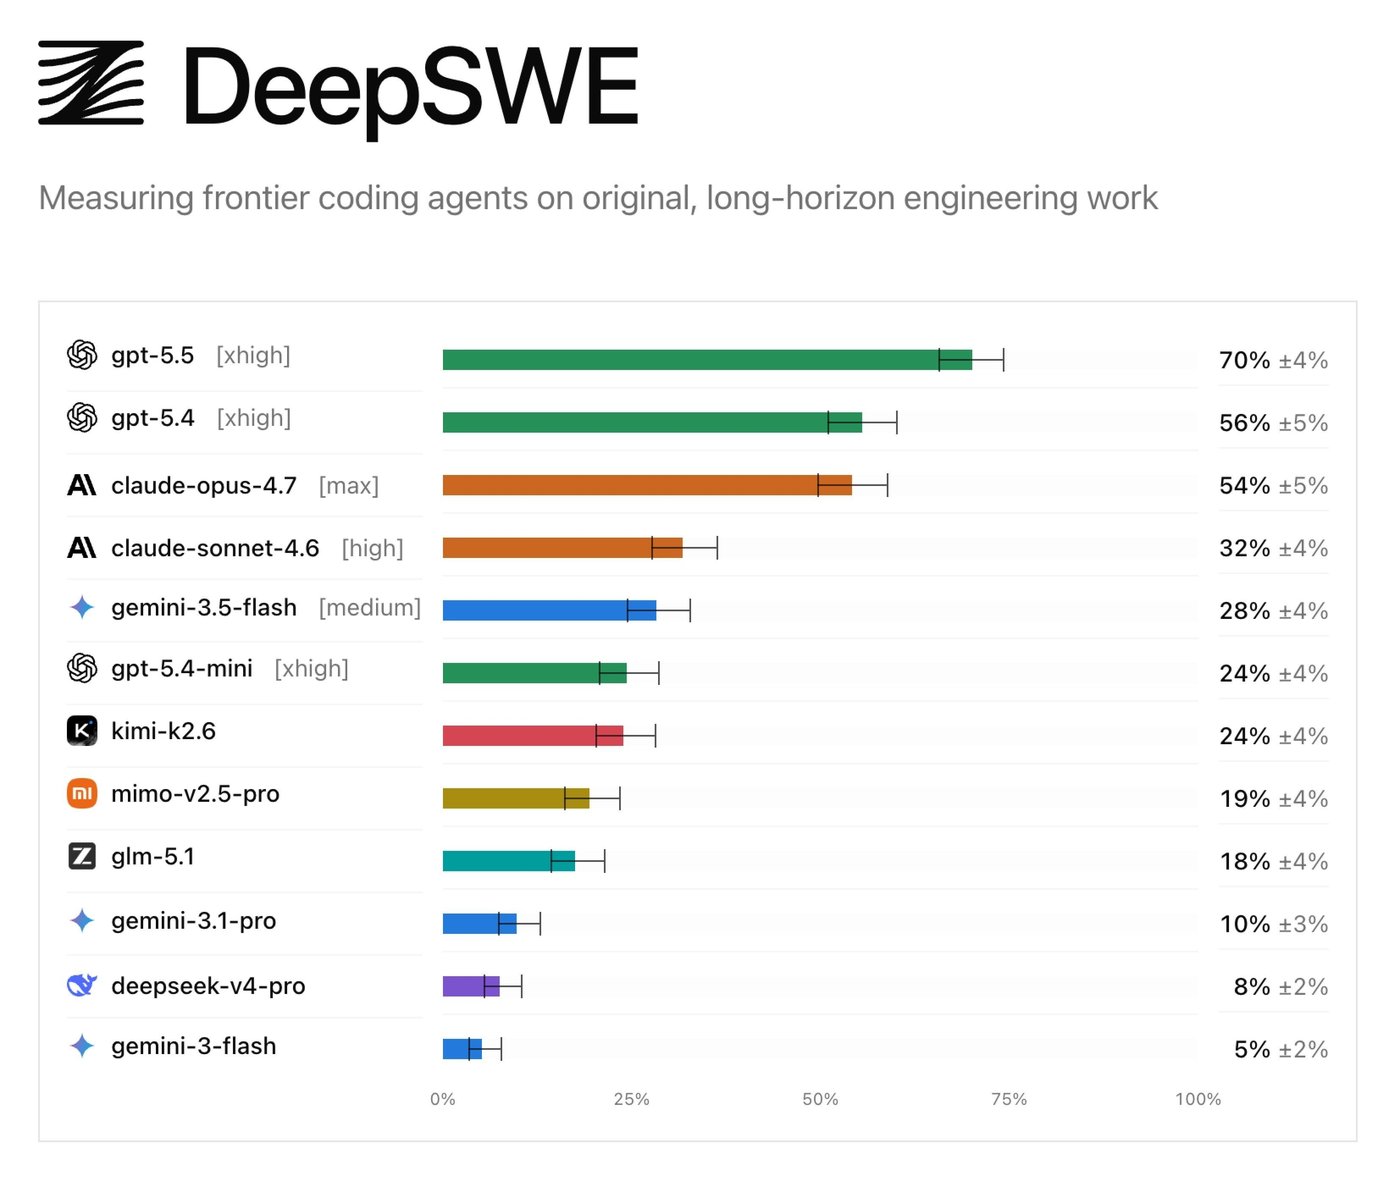
Chi usa coding agent ogni giorno sa già che i leaderboard pubblici raccontano solo una parte della storia. I modelli sembrano vicini sulla carta, ma nella pratica le differenze si sentono chiaramente. Serena Ge di Datacurve ha formalizzato questo problema con DeepSWE, un nuovo standard per valutare i modelli di coding in scenari agentici reali.
Perché i benchmark classici non bastano
Sui leaderboard tradizionali i top model si accumulano in cima con punteggi simili, appiattendo le differenze. DeepSWE prova invece a misurare il divario che nella pratica quotidiana ogni sviluppatore percepisce: navigazione del codebase, modifiche multi-file, iterazione con i tool, verifica dei fix e capacità di portare a termine task veri da software engineering.
Questo lo rende particolarmente utile per chi lavora con agenti da terminale, coding assistant e workflow di vibe coding: somiglia di più al lavoro reale rispetto ai test troppo puliti o troppo sintetici.
Il punto chiave: non basta "rispondere bene"
Il messaggio di Datacurve è diretto. Non conta solo se un modello sa rispondere in modo corretto a una domanda isolata, ma se riesce a:
- navigare una codebase complessa;
- fare edit coerenti su più file;
- usare i test per verificare i propri fix;
- non perdersi nel workflow quando il contesto cresce.
È una distinzione importante: un modello che eccelle su prompt brevi può degradare rapidamente quando il task diventa lungo, rumoroso e pieno di dipendenze.
Perché può cambiare la conversazione sui coding agent
Se DeepSWE prende piede come riferimento, potrebbe diventare uno strumento più utile per confrontare agenti come Claude Code, Codex, Cursor, OpenCode e gli altri. Per noi sviluppatori, il valore non è il punteggio in sé, ma capire quali modelli reggono davvero su task scomodi e prolungati.
I benchmark troppo "puliti" tendono a premiare la risposta rapida e precisa su input controllati. Il margine tra un modello buono e uno ottimo, invece, emerge quasi sempre nel momento in cui il problema si complica.
Vale la pena seguire come si evolverà l'adozione di DeepSWE nella community: potrebbe diventare la misura più onesta di cosa funziona davvero nell'ingegneria del software assistita da AI.
Voi avete già una metrica o un test personale per valutare i coding agent sul lavoro reale, o vi affidate ancora ai leaderboard pubblici?
📌 Questo articolo riassume una discussione su r/vibecodingitalia. Leggi il post originale.
Scritto da
Michael Gasperini@TheStreamCode
Full Stack Developer
Creatore di Vibe Coding Italia, la community italiana sull’intelligenza artificiale. Progetta e sviluppa prodotti con l’AI e ne racconta l’applicazione pratica attraverso guide e articoli.
Jev: il modello per decisioni che non scrive nemmeno una riga di testo
Jev di TypeSafe AI è il primo modello System One: decisioni strutturate con probabilità calibrate in 70-500 ms, per routing e guardrail degli agenti.
Leggi articolo
Oh My Pi (omp): il fork di Pi con LSP, subagenti e memoria già dentro
Oh My Pi è il fork MIT del coding agent Pi con LSP attivo di default, Agent Hub per i subagenti e memoria per progetto. Oltre 60 provider supportati.
Leggi articolo
OpenAI rilascia GPT-6 Astra: il suo miglior modello di coding finora, e il primo designato Critical in cybersecurity
OpenAI rilascia GPT-6 Astra: record su Terminal-Bench 4.0, listino $10/$50, primo modello Critical in cybersecurity con capacità al lancio limitate.
Leggi articolo