//Novità2 min di lettura
Grok 4.6 evolve il 4.5: più focus su agenti long-running e workflow visuali
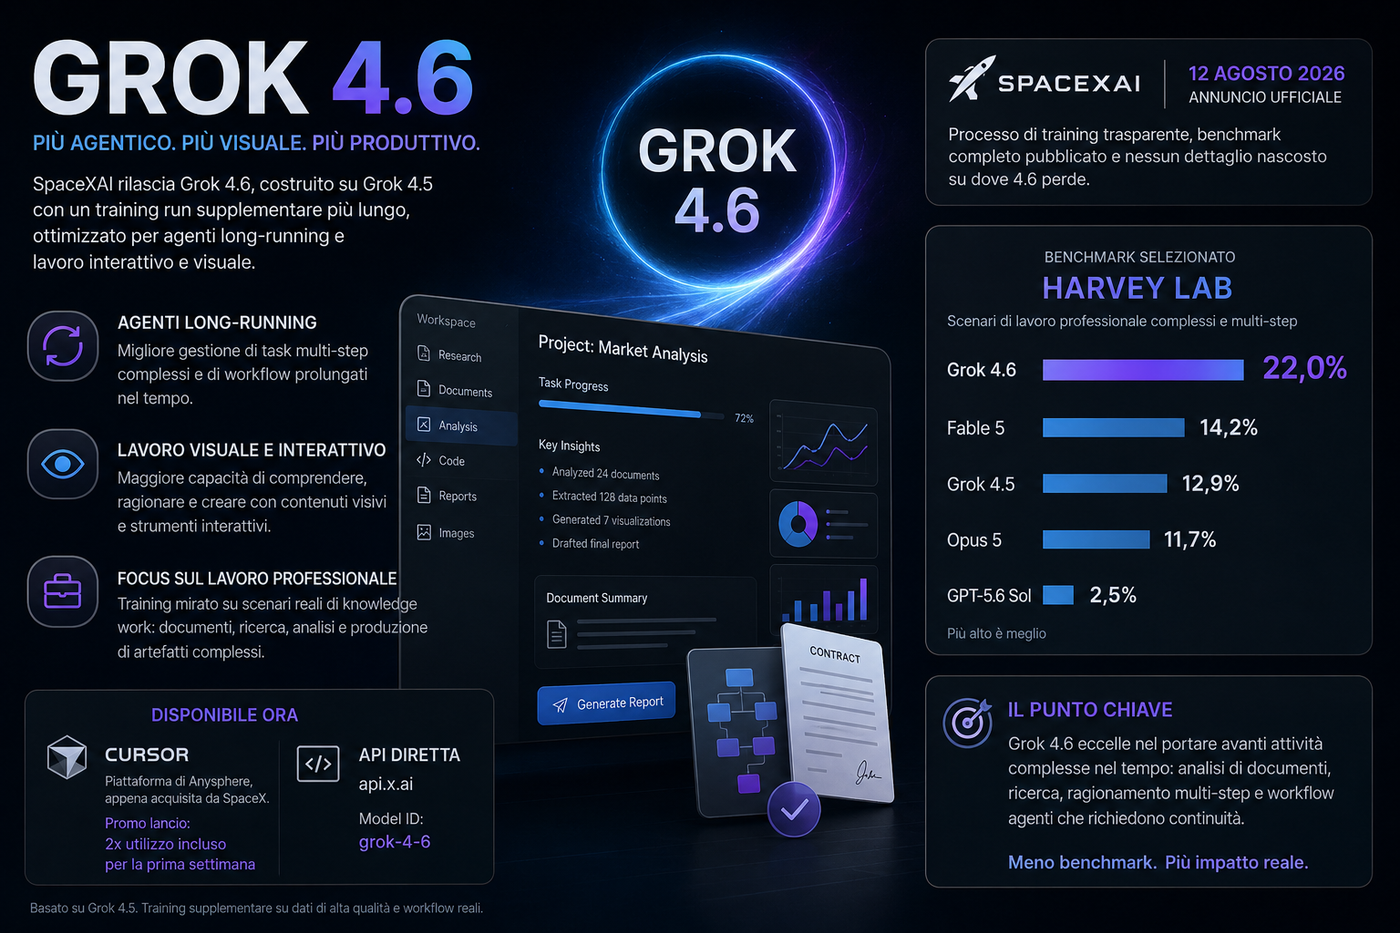
SpaceXAI ha rilasciato Grok 4.6 il 12 agosto con un blog post ufficiale. Il posizionamento è chiaro fin dal primo paragrafo: non si tratta di una nuova architettura di base, ma di un modello costruito su Grok 4.5 attraverso un training supplementare più lungo, ottimizzato soprattutto su due fronti: agenti long-running e lavoro interattivo e visuale.
Uno degli aspetti più interessanti del lancio è la trasparenza con cui SpaceXAI descrive il processo. Il blog entra nel dettaglio del training, pubblica una tabella benchmark completa con i principali competitor e mostra anche i casi in cui Grok 4.6 non risulta il modello migliore.
Per chi vuole provarlo subito, Grok 4.6 è già disponibile su Cursor, la piattaforma sviluppata da Anysphere, società appena acquisita da SpaceX. Per il lancio è prevista anche una promozione con 2x utilizzo incluso durante la prima settimana. Rimane inoltre disponibile la consueta API diretta di SpaceXAI tramite api.x.ai, utilizzando il model ID grok-4-6.
Il dato forse più interessante arriva però da Harvey LAB, benchmark orientato a scenari di lavoro professionale complessi e multi-step. Grok 4.6 raggiunge il 22,0%, contro il 14,2% di Fable 5 e appena il 2,5% di GPT-5.6 Sol.
È probabilmente questo il risultato che descrive meglio il posizionamento del modello. Più che puntare esclusivamente sul coding puro o sui benchmark generalisti, Grok 4.6 sembra mostrare il proprio vantaggio quando deve lavorare più a lungo su attività articolate: analisi di documenti, ricerca, produzione di artefatti, ragionamento multi-step e workflow agentici che richiedono continuità nel tempo.
In altre parole, il salto rispetto a Grok 4.5 sembra essere soprattutto operativo. Se il vostro caso d'uso richiede un modello capace di portare avanti attività professionali complesse, interagire con strumenti e mantenere il filo del lavoro per periodi più lunghi, Grok 4.6 potrebbe essere uno dei modelli più interessanti da testare in questo momento.
Scritto da
Gaetano D'Orsi@gdorsi44
Consulente IT
Autore e moderatore di Vibe Coding Italia. Consulente informatico appassionato di IA applicata nell’industria IT, e non solo.
Jev: il modello per decisioni che non scrive nemmeno una riga di testo
Jev di TypeSafe AI è il primo modello System One: decisioni strutturate con probabilità calibrate in 70-500 ms, per routing e guardrail degli agenti.
Leggi articolo
Oh My Pi (omp): il fork di Pi con LSP, subagenti e memoria già dentro
Oh My Pi è il fork MIT del coding agent Pi con LSP attivo di default, Agent Hub per i subagenti e memoria per progetto. Oltre 60 provider supportati.
Leggi articolo
OpenAI rilascia GPT-6 Astra: il suo miglior modello di coding finora, e il primo designato Critical in cybersecurity
OpenAI rilascia GPT-6 Astra: record su Terminal-Bench 4.0, listino $10/$50, primo modello Critical in cybersecurity con capacità al lancio limitate.
Leggi articolo